引言
8 月初,某大型电子制造企业的 MES 在现场反馈扫码卡顿。配合同事定位根因后,我们先做了 Nginx 配置优化和日志增强,短暂恢复。但问题反复出现,倒逼我们把动作从“应急”升级为“系统性治理”。这条路径对做制造业数字化的人很有参考价值。
应急阶段:先止血,再找因
应急排查的逻辑很朴素:现场反馈卡顿,先确认是接口链路阻塞还是数据库压力。最初的现象是接口资源长时间无法释放,于是用新增负载站点、调整 Nginx 配置、暂停慢查询报表服务等方式先止血。
这个阶段的目标是恢复产线,不是定根因。但每一步操作都要留痕——截图、异常日志、压测依据,后面深度排查时这些都成了证据。
治理阶段:用工具把“感觉”变成“数据”
反复出问题后,我们引入了链路追踪工具(SkyWalking)来定位瓶颈,并导出数据库 AWR 报告交给分析。结论逐渐清晰:原本在 Windows 上运行的某缓存组件稳定性不足,是反复卡顿的诱因之一。
随后把缓存服务切换到更稳定的运行环境,并完成代码优化合并,产线过站恢复正常。同时引入轻量级监控工具(Netdata)观察缓存状态,把“凭经验判断”变成“看指标说话”。
一个经验:性能问题不要只靠重启和调参,要用链路追踪 + 数据库报告把瓶颈量化,才能避免“今天好了明天又坏”。
设备数采:SMT 产线的三类坑
同一阶段,我们还推进了 SMT 产线多类设备的数据采集,踩的坑更具体:
AOI 过站失效:根因是设备上传的某个参数传了空字符串,导致后台不走默认逻辑。这类问题表面是“过站失败”,实际是设备侧报文不规范,需要在接口侧做默认值兜底。
回流焊/波峰焊 CSV 采集:方案按文件日期解析、跨日期数据划分规则来设计。难点在于设备导出的文件格式和命名不一定稳定,解析逻辑要把“日期边界”和“异常行”都考虑进去。
SPI 偶发失败:多为字符转换问题,需要和设备侧确认编码与字段长度约束。
设备数采的本质,是把“设备说了什么”翻译成“系统能用的数据”。报文规范、编码、边界,这三处最容易出问题。
从被动到主动
性能治理和设备数采都暴露同一个问题:被动响应永远慢半拍。后续我们计划把链路追踪常态化部署,并把数采方案沉淀成可复用的文档,让类似问题发生时能快速定位。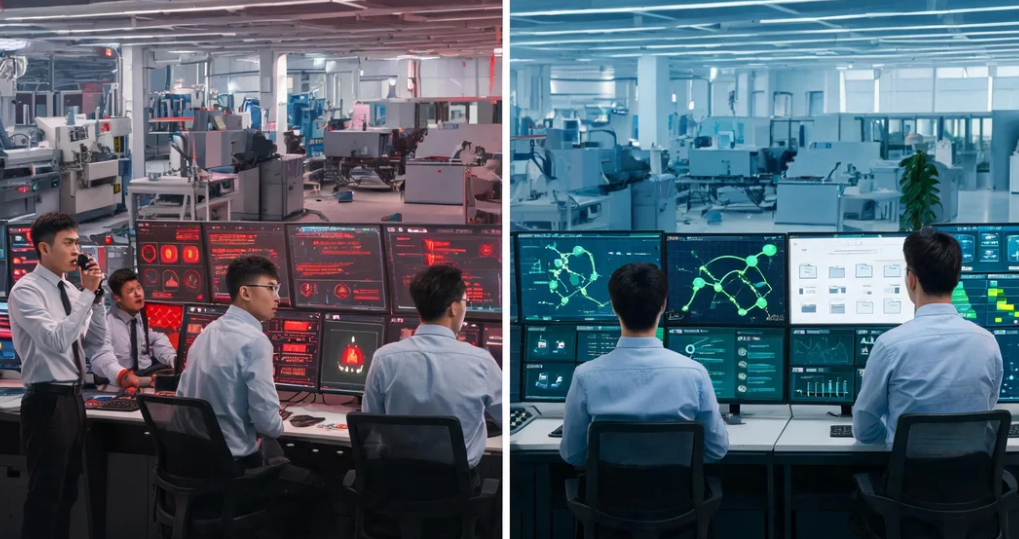
本文所述治理路径,基于笔者所在团队在精工智能数字化工厂相关项目中的实施经验;把应急动作沉淀为系统性能力,正是制造业数字化软件从“能跑”走向“稳跑”的关键一步。